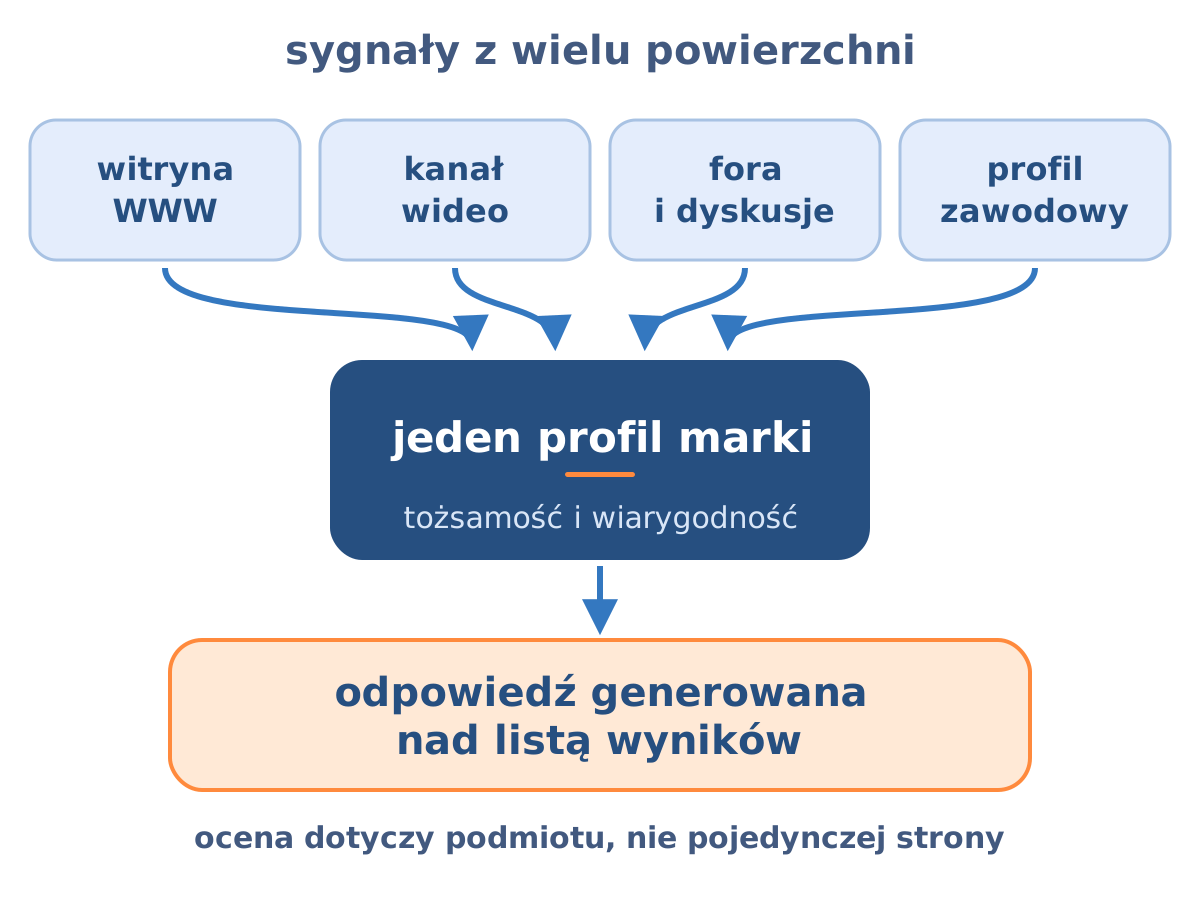
Algorytm Google to wielowarstwowy ekosystem, który wykracza poza analizę semantyczną dokumentów i skupia się na walidacji tożsamości oraz autorytetu podmiotów internetowych. System nie ocenia już izolowanych stron, lecz integruje sygnały z wielu powierzchni — od witryn WWW, przez kanały wideo, po dyskusje na forach i profile zawodowe — żeby ustalić rzeczywiste granice i wiarygodność marki. W dobie generatywnej sztucznej inteligencji fundamentem widoczności są udokumentowane doświadczenie i ludzka perspektywa, które zasilają odpowiedzi generowane nad listą wyników.
Co to jest algorytm Google?
Algorytm Google to zintegrowany ekosystem technologii obliczeniowych i modeli generatywnych, pełniący funkcję silnika odpowiedzi oraz kuratora globalnych zasobów informacyjnych. Architektura opiera się na ciągłym przekształcaniu danych nieustrukturyzowanych w semantyczny Graf Wiedzy. Operacyjnie działa jako sekwencja wyspecjalizowanych mikrousług: od ingestii i kanonikalizacji danych (Doc Joiner, Caffeine), przez semantyzację i wektoryzację (Mustang, WebRef, RankEmbed), aż po końcowe pobieranie informacji (MUVERA).
Współczesny algorytm kładzie nacisk na analizę encji i intencji użytkownika (Pianno, BERT, Gemini). Kluczowym mechanizmem weryfikacyjnym jest synteza danych behawioralnych (Navboost) z obiektywnymi wskaźnikami autorytetu źródła (NSR, HGR). Pozwala to na dynamiczne przyznawanie widoczności na podstawie paradygmatu E-E-A-T. Produktem końcowym jest syntetyczna odpowiedź (AI Overviews), która priorytetyzuje podmioty o udokumentowanym wkładzie merytorycznym (Information Gain) oraz nienagannej charakterystyce techniczno-użytkowej (Core Web Vitals, ClutterScore).
Kluczowe mikro-algorytmy i systemy Google Search
System składa się z setek mikrousług, które dzielą się na cztery kategorie funkcjonalne.
1. Fundamenty i infrastruktura
- Doc Joiner — konsoliduje sygnały o dokumencie i wybiera wersję kanoniczną.
- Mustang — system indeksowania i wstępnej selekcji miliardów stron.
- Navboost — analizuje interakcje użytkowników w różnych przedziałach czasowych (krótkoterminowe trendy i długoterminowa reputacja), żeby promować strony, które realnie rozwiązują problem.
- NSR (Normalized Site Rank) — agreguje sygnały jakościowe dla całej domeny, wpływając na to, z jakim zaufaniem traktowane są nowe treści z danej witryny.
- Percolator — pozwala na przyrostowe indeksowanie: zamiast czekać na pełną aktualizację bazy, natychmiast wprowadza zmiany w dokumentach, które często się zmieniają.
- Indexing Tiering — warstwowanie indeksu. Zasoby dzielą się na warstwę najszybszego dostępu oraz warstwy rzadszego dostępu dla treści niszowych.
2. Semantyka i AI (rozumienie intencji)
- RankBrain — pierwszy system AI w wyszukiwarce, pomagający rozumieć zapytania nigdy wcześniej niewidziane przez łączenie słów w koncepty.
- BERT — model przetwarzania języka naturalnego analizujący kontekst każdego słowa w zdaniu zamiast czytania słowo po słowie.
- MUM (Multitask Unified Model) — system kolejnej generacji wobec BERT-a: łączy informacje z tekstu, obrazów i wideo oraz przenosi wiedzę między językami, dzięki czemu odpowiedź może powstać ze źródła w innym języku niż zapytanie.
- MUVERA — system wielowektorowego pobierania danych, precyzyjniej łączący złożone intencje użytkownika z głębokim kontekstem treści.
- WebRef (Entity Annotator) — etykietuje słowa na stronie jako konkretne byty z Grafu Wiedzy. To dzięki niemu wyszukiwarka wie, że „Jaguar” w tekście oznacza samochód, a nie zwierzę.
- RankEmbed — odpowiada za wektoryzację zapytania: zamienia pytanie na ciąg liczb, co pozwala dopasować stronę, która nie zawiera ani jednego słowa z zapytania, ale odpowiada na jego sens.
3. Filtry jakości i UX
- Helpful Content System — zintegrowany z głównym algorytmem; ocenia, czy treść powstała dla ludzi, czy pod wyszukiwarkę.
- Twiddlers — mikrousługi działające na końcu procesu rankowania; dbają m.in. o różnorodność wyników i filtrują spam.
- SpamBrain — system oparty na AI do walki z nowymi formami spamu, w tym z masowo generowaną treścią niskiej jakości.
- QualityBoost — mechanizm ostatecznej korekty rankingu na podstawie sygnałów E-E-A-T.
- ClutterScore — ocenia zaśmiecenie strony: stosunek reklam do treści oraz to, czy elementy nakładkowe uniemożliwiają konsumpcję materiału.
- Instant Glue — decyduje o wymieszaniu wyników: czy pod danym zapytaniem lepiej wyświetlić wideo, mapę, czy listę produktów.
- Product Review Update — ocenia recenzje produktów, premiując dowody fizycznego testowania zamiast kopii opisu producenta.
4. Systemy specjalistyczne
- FreshDocs — odpowiada za błyskawiczne indeksowanie i promowanie świeżych treści (Query Deserves Freshness).
- Kgraph (Knowledge Graph) — silnik zarządzający faktami o świecie, generujący panele wiedzy i odpowiedzi bezpośrednie.
- AI Overviews — system syntezy generujący odpowiedzi nad wynikami wyszukiwania na podstawie najbardziej wiarygodnych źródeł.
- BabyNav — testuje nowe, nieznane jeszcze strony na wysokich pozycjach, żeby zebrać pierwsze dane o kliknięciach.
- Term Weighting (DeepRank) — decyduje, które słowo w zapytaniu jest najważniejsze; w zdaniu „jak zrobić kawę bez kofeiny” kluczowe jest „bez”.
- Personalization Engine — dostosowuje wyniki do interakcji użytkownika z pozostałymi usługami, przy deklarowanej dbałości o unikanie zamkniętych baniek informacyjnych.
Jaką rolę pełni sztuczna inteligencja w rankingu?
Sztuczna inteligencja działa jako silnik odpowiedzi i centralny system operacyjny zarządzający mikro-algorytmami. Modele analizują intencje użytkowników i rozumieją kontekst w tekście, obrazach i wideo. Odpowiedzi generatywne korzystają z wiarygodnych źródeł, a SpamBrain wraz z mechanizmami E-E-A-T filtruje treści niskiej jakości. MUM i BERT są dziś częściami składowymi ekosystemu Gemini, a Helpful Content stanowi integralny element algorytmu rdzenia.
Jak integracja Gemini zmieniła rdzeń wyszukiwarki?
Modele z rodziny Gemini zdominowały warstwę rozumienia zapytań, zastępując lub głęboko integrując starsze systemy. Zasilają tryb konwersacyjny w wyszukiwarce, który pozwala prowadzić kilka wyszukiwań naraz w odpowiedzi na jedno złożone pytanie. Dodatkowo mechanizm ugruntowania w wynikach wyszukiwania łączy model generatywny z indeksem w czasie rzeczywistym, dzięki czemu fakty są weryfikowane w bieżącym indeksie zamiast odtwarzane z pamięci modelu.
Jak działa algorytm Google w praktyce
W praktyce system składa się z wielu wyspecjalizowanych algorytmów wykonujących określone zadania w cyklu przetwarzania danych. Wyciek dokumentacji API z 2024 roku oraz późniejsze aktualizacje odsłoniły nazwy i funkcje wielu wewnętrznych systemów. Proces transformuje surowe dane z miliardów witryn w spójne odpowiedzi, opierając się nie na słowach, lecz na tożsamości encji i ich reputacji.
1. Ingestia i orkiestracja danych
- Discovery: Roboty Googlebot przesyłają dane do infrastruktury Caffeine, a tempo wykrywania zmian podnoszą aktualne mapy witryny i linkowanie wewnętrzne.
- Zarządzanie budżetem crawlowania: systemy jakościowe decydują o priorytecie indeksowania; strony o niskiej wartości są odwiedzane rzadziej.
- Kanonikalizacja (Doc Joiner): konsolidacja sygnałów z duplikatów i różnych wersji językowych w jeden kanoniczny rekord dokumentu.
2. Semantyzacja i Graf Wiedzy
- Indeksowanie (Mustang): dokument trafia do bazy głównej i jest przetwarzany semantycznie.
- Identyfikacja encji (WebRef): rozpoznanie bytów i przypisanie im identyfikatorów w Grafie Wiedzy.
- Mapowanie intencji (Pianno): analiza wielowymiarowej intencji zapytania — informacyjnej, transakcyjnej, nawigacyjnej.
- Mapowanie społecznościowe: weryfikacja powiązań autora treści z profilami i publikacjami w celu budowy profilu zaufania.
- MUVERA: działa na etapie wstępnej selekcji i pobierania danych, łącząc semantyzację z rankingiem końcowym. Realizuje dwuetapowy proces: szybką selekcję oraz głębokie dopasowanie wielowektorowe. Treść, która nie przejdzie tego filtru, w ogóle nie trafi do końcowej oceny rankingowej.
3. Walidacja jakościowa i kontekstowa
- NSR: ocena jakości na poziomie całej domeny; system wielowymiarowych wyników jakości określający klaster tematyczny witryny.
- HGR: ocena zgodności z wytycznymi E-E-A-T.
- UX i szybkość: weryfikacja Core Web Vitals (LCP, INP, CLS) oraz ClutterScore.
4. Ranking AI i filtracja
- Rozumienie kontekstowe: osadzenia wektorowe dopasowują znaczenie treści, nie same słowa kluczowe.
- Navboost: korekta rankingu na podstawie historycznych logów wyszukiwania; działa na dwóch etapach — selekcji wstępnej i re-rankingu.
- SpamBrain: eliminacja manipulacji odnośnikami oraz treści generowanych automatycznie bez unikalnej wartości.
5. Personalizacja i synteza lokalna
- Kontekst lokalny: dostosowanie wyników do lokalizacji użytkownika i języka zapytania.
- Integracja wertykalna: agregacja modułów — map, zakupów, wideo — w jeden interfejs.
- Świeżość: decyzja, czy użytkownik potrzebuje najnowszych informacji, czy sprawdzonych faktów.
6. Finalizacja i warstwa generatywna
- AI Overviews: synteza odpowiedzi z wielu źródeł, prezentowana nad listą linków.
- Information Gain Score: sprawdzenie, czy strona wnosi coś nowego wobec tych, które już zajmują czołowe pozycje. Strona będąca kopią może zostać ukryta na etapie końcowej korekty.
Strategie optymalizacji pod algorytm
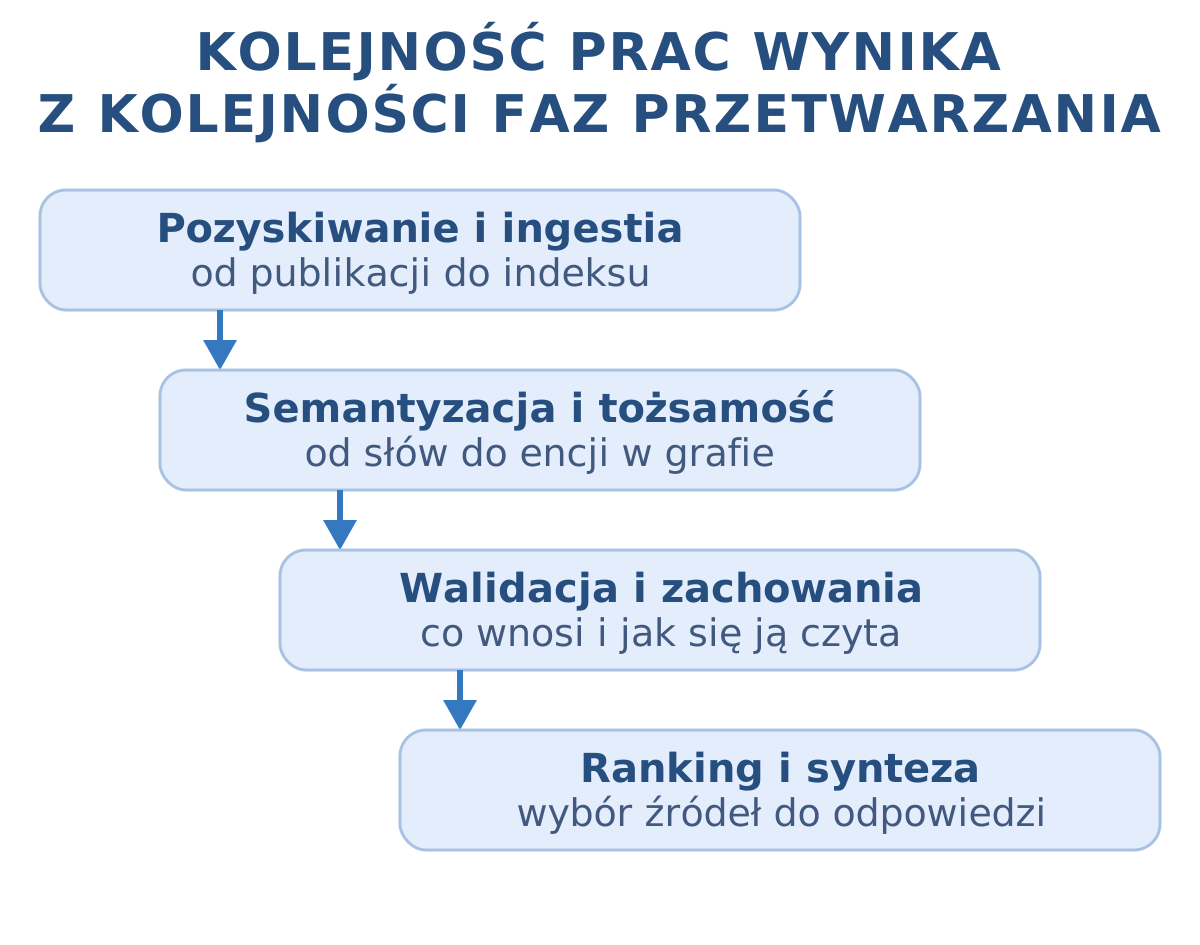
Stabilizacja algorytmu jako silnika odpowiedzi wymusza zmianę strategii optymalizacji: zamiast walki o kliknięcie — pozycjonowanie marki jako wiarygodnego źródła danych wewnątrz ekosystemu AI. Poniższe strategie są uporządkowane zgodnie z cyklem przetwarzania: od technicznego pozyskania strony, przez zrozumienie jej znaczenia, po ranking i syntezę odpowiedzi.
Faza 1: pozyskiwanie i ingestia
W fazie ingestii optymalizacja skupia się na maksymalnym skróceniu ścieżki między publikacją a indeksem przez eliminację szumów technicznych i zarządzanie budżetem crawlowania. Kluczowe jest utrzymanie aktualnych map witryny i poprawnych nagłówków HTTP, a w wyszukiwarkach, które go obsługują (Bing, Yandex), także protokołu IndexNow, oraz rygorystyczna kontrola kanonikalizacji, która zapobiega marnowaniu zasobów robota na analizę duplikatów. Strategia wymaga również optymalizacji linkowania wewnętrznego i map stron pod kątem priorytetyzacji unikalnych treści o wysokim wskaźniku Information Gain.
W jaki sposób efektywność energetyczna wpływa na budżet crawlowania?
Dążenie do optymalizacji kosztów obliczeniowych sprawia, że budżet crawlowania zależy od wydajności infrastruktury witryny. Robot szybciej porzuca serwisy ociężałe, dlatego kluczowa jest techniczna optymalizacja kodu. Priorytetem pozostaje stabilność interakcji (INP) oraz lekkość serwisu. Słaby czas odpowiedzi serwera bezpośrednio degraduje widoczność nowych podstron.
Jak optymalizować renderowanie pod Web Rendering Service?
Optymalizacja pod WRS sprowadza się do maksymalizacji wydajności obliczeniowej witryny. Kluczowe jest wdrożenie renderowania po stronie serwera lub buforowania na brzegu sieci, żeby dostarczyć robotowi gotowy kod HTML i wyeliminować ryzyko luki indeksacyjnej związanej z asynchronicznym przetwarzaniem JavaScriptu. Odchudzanie kodu pozwala botowi zrozumieć kontekst encji bez kosztownego renderowania wizualnego.
Jak optymalizować pod indeksowanie w Caffeine i Percolator?
Optymalizacja pod infrastrukturę Caffeine i Percolator wymaga przejścia z pasywnego oczekiwania na aktywne sygnalizowanie zmian: aktualne mapy witryny, poprawny nagłówek Last-Modified, a w wyszukiwarkach obsługujących ten protokół — IndexNow. Pozwala to systemowi na inkrementalne aktualizowanie indeksu bez obciążania serwerów i oznacza priorytetyzację świeżości przez dynamiczne linkowanie wewnętrzne.
Jak optymalizować pod Doc Joiner?
Optymalizacja pod Doc Joiner polega na eliminacji szumu informacyjnego i dostarczaniu spójnych sygnałów o wersji kanonicznej dokumentu — przez rygorystyczne stosowanie rel="canonical" oraz czystą strukturę URL. Skoro system odpowiada za konsolidację danych o stronie, kluczowe jest użycie semantycznego HTML5 dla wyraźnego oddzielenia treści głównej od elementów stałych. W praktyce oznacza to rezygnację z powielania treści na rzecz silnych, unikalnych jednostek informacyjnych.
Faza 2: semantyzacja i mapowanie tożsamości
W tej fazie optymalizacja polega na nadaniu treściom struktury zrozumiałej dla systemów WebRef i Pianno, co pozwala algorytmowi przypisać witrynę do konkretnych encji w Grafie Wiedzy. Strategia opiera się na danych strukturalnych oraz budowaniu jasnych powiązań między autorem a tematem. Zamiast nasycania tekstu frazami liczy się autorytet tematyczny i jednoznaczna terminologia, którą modele wektorowe potrafią bezbłędnie zmapować.
Jak optymalizować pod system MUVERA?
Ponieważ MUVERA analizuje treść na poziomie fragmentów, a nie całych stron, optymalizacja polega na dzieleniu tekstu na wyraźne, autonomiczne sekcje z własnymi nagłówkami. Każdy akapit powinien stanowić kompletną odpowiedź na konkretny aspekt tematu. System premiuje fragmenty wnoszące nowe informacje, dlatego zamiast powtarzania fraz liczy się wyczerpanie tematu. W praktyce MUVERA wymusza przejście od pisania artykułów do projektowania architektury odpowiedzi.
Jak optymalizować pod system WebRef?
Optymalizacja pod WebRef wymaga porzucenia nasycania tekstu frazami na rzecz budowania gęstości semantycznej i wysokiego wskaźnika istotności encji. Ponieważ WebRef działa jako pomost między tekstem a Grafem Wiedzy, proces zaczyna się od audytu encji i jawnego wskazania robotom relacji między nimi za pomocą danych strukturalnych JSON-LD. Skuteczna strategia polega na otaczaniu głównego podmiotu logicznymi współwystąpieniami i atrybutami, które system ekstrakcji może przypisać do profilu marki.
Jak optymalizować pod Graf Wiedzy?
Optymalizacja pod Graf Wiedzy polega na pozycjonowaniu marki jako źródła prawdy przez rygorystyczne zarządzanie spójnością atrybutów w całym ekosystemie cyfrowym. Proces wymaga wyznaczenia oficjalnego domu encji, na którym za pomocą danych strukturalnych definiuje się bazowe trójki (podmiot → predykat → obiekt), łącząc markę z uznanymi węzłami grafu. Autorytet encji buduje się przez dystrybucję spójnych danych w zewnętrznych bazach autorytatywnych oraz treści o gęstej topologii tematycznej.
Jak budować autorytet encji zamiast rankingu słów?
Ugruntowanie roli Grafu Wiedzy oznacza, że oceniany jest podmiot, a nie sama treść na stronie. Niezbędne jest wdrażanie danych strukturalnych zarówno dla produktów, jak i dla autorów. W ramach E-E-A-T nacisk pada na weryfikowalne poświadczenia autorów i przejrzystość źródeł, co bezpośrednio wpływa na obecność w modułach odpowiedzi generatywnych.
Jak optymalizować pod integrację powierzchni encji?
Optymalizacja pod integrację powierzchni encji wymaga przejścia od SEO na stronie do zarządzania reputacją encji w całym ekosystemie. Kluczowe jest budowanie spójnej tożsamości marki na wielu powierzchniach — serwisie wideo, platformie zawodowej, forach — i połączenie ich z domeną precyzyjnymi danymi strukturalnymi. Ponieważ algorytm ocenia autentyczność podmiotu, strategia opiera się na dowodach ludzkiej perspektywy, które system agreguje w jeden profil encji.
Jak optymalizować pod wektory intencji systemu Pianno?
Optymalizacja pod wektory intencji poprzedza wszystkie pozostałe prace, ponieważ ten system odpowiada za kategoryzację zapytań. Realizacja wymaga precyzyjnego mapowania lejka i tworzenia osobnych podstron dla różnych intencji — edukacyjnych i zakupowych. Analiza luki semantycznej wskazuje brakujące pojęcia, a sekcja pytań i odpowiedzi z bezpośrednimi rozstrzygnięciami ustawia witrynę jako źródło ostateczne.
Jak optymalizować pod Mustang i AI Overviews?
Optymalizacja opiera się na inżynierii akapitu oraz dostarczaniu faktów gotowych do syntezy. Kluczowe jest zachowanie eksperckiego sentymentu oraz modułowa budowa treści, która pozwala na parafrazowanie informacji bez utraty kontekstu. Skuteczność weryfikuje się w Search Console, gdzie dane o widoczności w odpowiedziach generatywnych potwierdzają przejście od rankingu linków do rankingu precyzyjnych odpowiedzi.
Faza 3: walidacja jakościowa i behawioralna
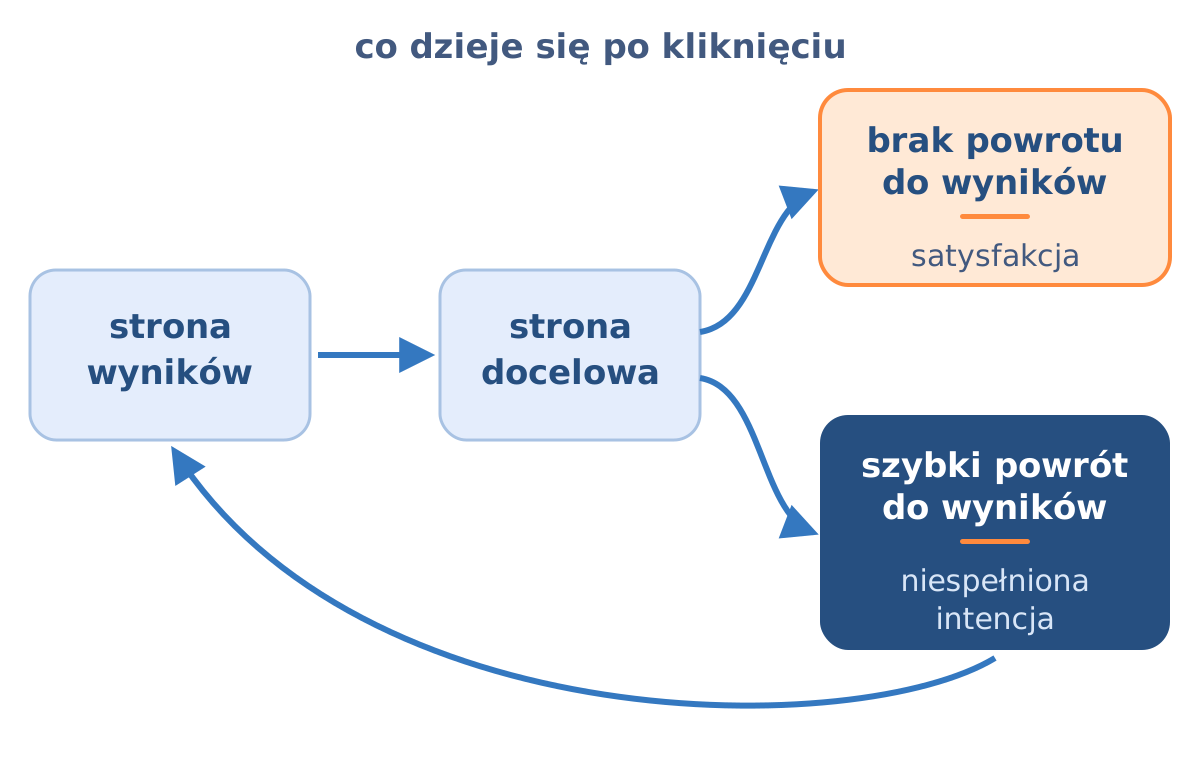
W fazie walidacji optymalizacja koncentruje się na jakości treści i użyteczności strony. Wymaga eliminacji elementów obciążających odbiór (ClutterScore) oraz poprawy wskaźników wydajności (Core Web Vitals). Celem jest budowa autentycznego zaangażowania: treść musi być zaprojektowana tak, żeby użytkownik znalazł odpowiedź na miejscu, zamiast wracać do wyników wyszukiwania.
Jak przeprowadzić audyt techniczny i wizualny?
Audyt techniczny stanowi fundament działań optymalizacyjnych. Szybkość ładowania jest krytyczna, dlatego proces naprawczy obejmuje weryfikację Core Web Vitals (LCP, INP, CLS) oraz analizę struktury URL. Niezbędna jest również optymalizacja mediów — opisy alternatywne i transkrypcje — żeby spełnić wymogi dostępności i ułatwić odczyt treści modelom.
Jak optymalizować pod ClutterScore?
ClutterScore jest komponentem systemu oceny doświadczeń użytkownika. Analizuje wizualne obciążenie poznawcze, obniżając ocenę stron, na których treść jest trudna do skonsumowania przez nadmiar szumu. Kluczowe parametry to udział treści głównej oraz stosunek powierzchni reklamowej do treści, mierzone przede wszystkim w obszarze widocznym bez przewijania. Optymalizacja wymaga audytu układu (treść widoczna natychmiast), rozsądnego rozmieszczenia reklam — bez wstrzykiwania ich w środek zdań — oraz redukcji elementów przyklejonych do krawędzi ekranu.
W jaki sposób tworzyć treści zgodne z E-E-A-T?
Tworzenie treści zgodnych z E-E-A-T wymaga eksponowania wiarygodności autorów. Kluczem jest Information Gain — ile nowych, unikalnych informacji zawiera strona w porównaniu do już zaindeksowanych. Promowane są treści tworzone przez ludzi dla ludzi, które realnie rozwiązują problem. Należy zadbać o biografie autorskie, cytowanie źródeł oraz dostarczanie własnych badań i analiz.
Jak optymalizować pod filtry treści niskiej jakości?
Optymalizacja wymaga skoncentrowania się na unikalności intelektualnej i wysokim wskaźniku Information Gain. Oznacza to dostarczanie nowych faktów, własnych analiz lub danych, których wyszukiwarka nie zaindeksowała jeszcze u konkurencji. Kluczową strategią jest przycinanie treści — usuwanie lub konsolidowanie cienkich artykułów w jeden autorytatywny materiał — oraz eliminacja powielania informacji.
Jak reagować na sygnały behawioralne Navboost?
Navboost jest jednym z najsilniejszych filtrów jakościowych, korygującym pozycje na podstawie satysfakcji użytkowników. Jeśli użytkownicy wracają do wyników po wejściu na stronę, strona traci autorytet. Skuteczna optymalizacja wymaga skupienia się na klikalności — przez angażujące tytuły — oraz na natychmiastowym spełnieniu intencji dzięki dobremu UX i szybkości ładowania.
Faza 4 i 5: ranking końcowy i synteza AI
Optymalizacja na etapie rankingu końcowego i syntezy skupia się na generowaniu Information Gain i dostarczaniu faktów, które modele mogą wyodrębnić dla modułów odpowiedzi generatywnych. Wymaga unikalnych spostrzeżeń, tabel i bezpośrednich odpowiedzi na pytania, co umożliwia systemom wektorowym precyzyjne dopasowanie treści do zapytań.
Jak optymalizować treści w semantycznej przestrzeni wektorowej?
Optymalizacja wymaga tworzenia treści o wysokiej gęstości informacyjnej, gdzie każdy fragment dostarcza unikalnej wartości. Zamiast nasycania tekstu frazami należy budować klastry tematyczne i stosować precyzyjną terminologię ekspercką. Takie podejście pozwala zakotwiczyć witrynę w przestrzeni wektorowej jako wiarygodne źródło danych.
Na czym polega optymalizacja pod Information Gain?
W dobie masowego generowania treści priorytet mają strony wnoszące unikalną wartość dodaną. Strategia polega na unikaniu powielania ogólnodostępnych faktów na rzecz autorskiego wkładu merytorycznego. Algorytm nagradza publikację własnych danych, studiów przypadku i autorskich rozstrzygnięć, których nie ma w innych bazach.
Jak adaptować strategię do zapytań bez kliknięcia?
Skoro odpowiedź pojawia się bezpośrednio w wynikach, klikalność przestaje być jedyną miarą sukcesu. Żeby znaleźć się w podsumowaniach generatywnych, treść musi być sformatowana czytelnie dla modelu — precyzyjne odpowiedzi na pytania, listy punktowane, tabele. Nową miarą staje się udział marki w odpowiedziach generatywnych. Jak przekłada się to na zakres pracy nad serwisem, opisuje strona usług.
Rozszerzone systemy jakości i autentyczności
W odpowiedzi na wzrost treści generowanych maszynowo wprowadzono mechanizmy obronne:
Sygnały autentyczności treści
weryfikacja, czy materiał pochodzi od ekspertów z udokumentowanym doświadczeniem. Sygnały E-E-A-T stały się technicznymi wagami w algorytmie.
Aktualizacja różnorodności
przeciwdziała dominacji dużych serwisów w wynikach, promując mniejszych twórców i unikalne perspektywy.
Site Authority
metryka autorytetu całej domeny, wpływająca na ranking każdej nowej podstrony.
OriginalContentScore
oddziela streszczenia od treści z unikalnymi danymi, zdjęciami i spostrzeżeniami.
Filtr stron osobistych
promuje treści z forów i blogów osobistych, uznawane za bardziej autentyczne.
FAQ — najczęściej zadawane pytania
Czy w erze odpowiedzi generatywnych i zapytań bez kliknięcia SEO nadal ma sens biznesowy?
Tak, zmienia się natomiast jego cel: zamiast walki o masowe wyświetlenia SEO staje się walką o ruch konwertujący oraz o obecność w syntezach AI. Obecność marki jako źródła buduje najwyższy poziom zaufania. Z biznesowego punktu widzenia optymalizacja pod pobieranie fragmentów i odpowiedzi generatywne sprawia, że docierają użytkownicy na późniejszych etapach lejka, szukający pogłębionej analizy albo konkretnej usługi — a ci konwertują wyraźnie lepiej niż ruch ogólny.
Czy wyszukiwarka karze za treści generowane przez AI i jak wykrywają je systemy takie jak SpamBrain?
Kara dotyczy braku nowej wartości, czyli niskiego Information Gain, a nie samego użycia narzędzi. SpamBrain i NSR analizują, czy tekst jest wyłącznie semantyczną parafrazą danych już obecnych w indeksie. Jeżeli algorytm uzna treść za pustą — bez nowych faktów, bez doświadczenia, bez danych specyficznych dla encji — strona zostaje zdewaluowana. Optymalizacja polega więc na wykorzystaniu modeli do strukturyzacji przy jednoczesnym nasycaniu treści unikalnymi danymi, których model sam nie wyprodukuje.